
El Problema de Noruega y Otras Trampas de YAML que JSON No Tiene
En YAML el código de país NO se convierte en false, on es un booleano y 1:20 puede ser una hora o el número 80. Un repaso honesto a las trampas del formato que se comió la configuración de DevOps.
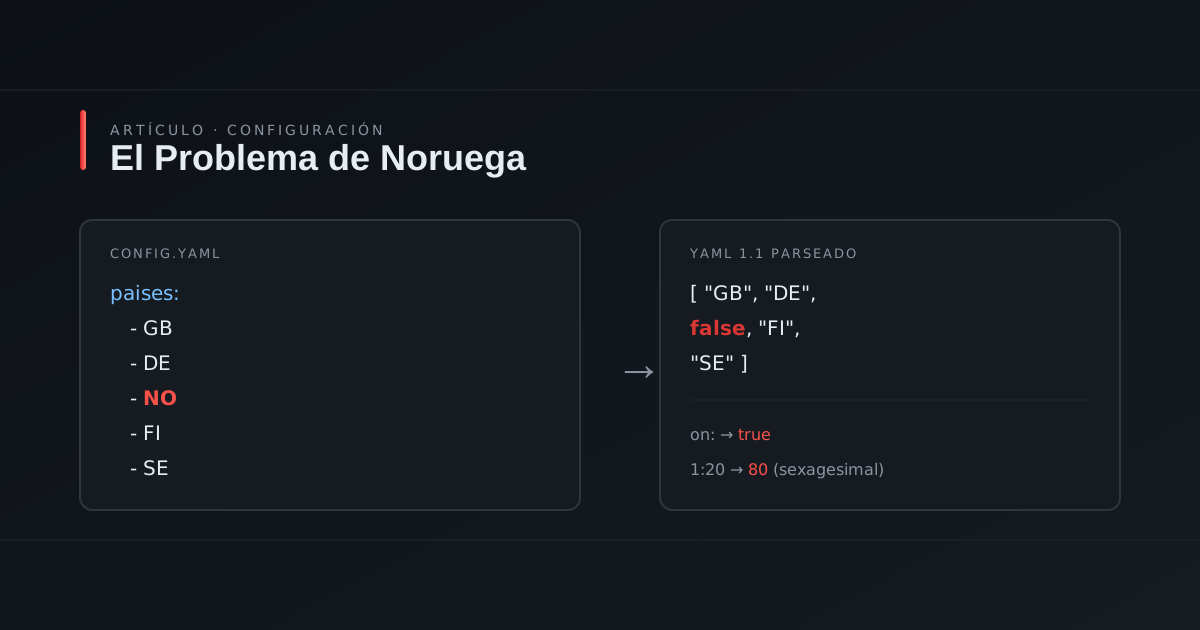
El país que desapareció de la configuración
Cuenta la leyenda —documentada, además— de alguien que mantenía una lista de países soportados en su fichero de configuración:
paises:
  - GB
  - IE
  - FR
  - DE
  - NO
  - FI
  - SE
Todo funcionaba perfectamente, excepto un detalle: los usuarios de Noruega no existían para el sistema. Porque en YAML 1.1, NO —el código ISO de Noruega— se parsea como false. La lista decía [GB, IE, FR, DE, false, FI, SE] y nadie lo notó hasta que los noruegos se quejaron.
Bienvenido al "Norway problem", la más famosa de las trampas de un formato que decidió que la comodidad de escribir era más importante que la previsibilidad de leer. Y como todo lo que toca Kubernetes, Docker Compose, GitHub Actions, Ansible y media infraestructura moderna está escrito en YAML, estas trampas te van a encontrar tarde o temprano.
Primero, lo justo: por qué YAML ganó
Es fácil burlarse de YAML, pero ganó por razones reales. Comparado con JSON tiene comentarios, que en un fichero de configuración son oro puro. No necesita comillas en casi nada. Las listas con guiones y los mapas con indentación se leen de un vistazo. Y permite anclas para no repetir bloques.
Para un docker-compose.yml que escribes a mano una vez al mes, todo eso es genuinamente agradable. El problema no es que YAML sea cómodo de escribir — es lo que pasa después, cuando otra cosa tiene que interpretar lo que escribiste.
La bomba de relojería: tipos implícitos
YAML 1.1 tiene una regla llamada "resolución de tags implícitos": el parser mira tu valor sin comillas e intenta adivinar el tipo. Y adivina con más entusiasmo que criterio.
Booleanos: once formas de decir verdadero
En YAML 1.1 todos estos son booleanos:
verdadero: [true, True, TRUE, yes, Yes, YES, on, On, ON, y, Y]
falso:     [false, False, FALSE, no, No, NO, off, Off, OFF, n, N]
Sí, on y off también. Lo que nos lleva a la perla de GitHub Actions:
# Este fichero empieza literalmente así:
on:
  push:
    branches: [main]
Si parseas un workflow de GitHub Actions con PyYAML (que implementa YAML 1.1), la clave on se convierte en True y tu diccionario tiene una llave booleana en lugar del string "on". La documentación de GHA tuvo que añadir notas avisando de esto. Piénsalo: el trigger más importante de CI/CD tiene el nombre de una palabra reservada accidental.
Números: el sexagesimal que nadie pidió
version: 3.10      # float 3.1 — tu Python 3.10 acaba de ser 3.1
port: 8080         # int, bien
reintento: 1:20    # sexagesimal en YAML 1.1: 60 + 20 = 80. Ochenta.
hex: 0xDEADBEEF    # int
grande: 1_000_000  # int con guiones bajos, depende del parser
Ese 1:20 es mi favorito personal: en YAML 1.1, los números en formato mm:ss se interpretan como sexagesimal. Alguien escribió un timeout de "un minuto veinte" y el sistema recibió el número 80. Funciona, sí. Hasta que lo parseas con otra librería y deja de funcionar.
Null: vacío de cinco formas distintas
a: ~
b: null
c: Null
d: NULL
e:                 # esto también es null
Cinco maneras de decir "nada". Y combinado con lo anterior: value: NONE no es null — es el string "NONE" — pero value: None... depende de tu parser. Divertido en producción.
La lotería de los parsers: 1.1 contra 1.2
YAML 1.2 (2009, hace ya sus años) corrigió gran parte de esto: los booleanos son solo true/false, el sexagesimal desapareció, NO vuelve a ser un string. Problema resuelto.
Excepto que no todo el mundo implementa YAML 1.2. Y aquí está el verdadero peligro: el mismo fichero produce resultados distintos según quién lo lea.
| Ecosistema | Parser habitual | Versión |
|---|---|---|
| Python | PyYAML | 1.1 (sí, en 2026) |
| Ruby | Psych | 1.1 |
| Go | yaml.v3 | 1.2 core, con matices |
| JavaScript | yaml / js-yaml | 1.2 |
| Kubernetes | su sig-yaml | vía JSON, otra capa más |
Resultado: tu config.yaml con deploy: on significa true para el script de Python de tu compañero y "on" para tu herramienta en Node. Mismo fichero, dos realidades. La regla de supervivencia es una sola: en YAML, pon comillas a todo lo que sea un string. "no", "3.10", "on", "1:20". Las comillas son el único antídoto contra la adivinación.
Anclas, aliases y la bomba de los mil millones de risas
YAML tiene un sistema de reutilización elegante: defines un bloque con &nombre y lo reutilizas con *nombre, o lo fusionas en otro mapa con <<: *nombre:
defaults: &defaults
  retries: 3
  timeout: 30

produccion:
  <<: *defaults
  timeout: 60
Bonito y útil. Pero los aliases pueden anidarse, y un parser ingenuo puede expandir esto:
a: &a ["x","x","x","x","x","x","x","x","x","x"]
b: &b [*a,*a,*a,*a,*a,*a,*a,*a,*a,*a]
c: &c [*b,*b,*b,*b,*b,*b,*b,*b,*b,*b]
# ... unos niveles más y tienes miles de millones de nodos en memoria
Es el "billion laughs attack": un YAML de unos pocos KB que consume toda tu RAM al parsearlo. Los parsers modernos tienen límites, pero es una categoría de DoS que JSON simplemente no puede expresar. Si alguna vez aceptas YAML de usuarios externos —malas noticias si es así—, valida y limita el parser.
Las trampas de escritura que no son de tipos
Aunque escapes de la inferencia de tipos, YAML tiene minas puramente sintácticas:
Tabs prohibidos
YAML usa solo espacios para indentar. Un tab escondido entre espacios rompe el parseo con errores que rara vez apuntan a la línea correcta. Si tu editor mezcla ambos, configúralo para YAML antes de que lo descubras en un apply a las 2 AM.
Las listas al nivel equivocado
servidores:
- web1    # esto es válido: el guion puede ir al nivel de la clave
  - web2  # esto TAMBIÉN es válido en otro estilo
Ambas formas son legales y significan lo mismo, pero mezclarlas en el mismo fichero invita a errores. Y el clásico:
comando: echo: hola      # ERROR: ":" dentro del valor rompe el mapa
comando: "echo: hola"    # bien
Dos puntos seguidos de espacio dentro de un valor sin comillas hacen que el parser crea que hay otra clave. Comillas. Siempre.
Los bloques multilínea que nadie recuerda
literal: |        # preserva saltos de línea
  línea 1
  línea 2
plegado: >        # junta las líneas con espacios
  esto se
  convierte en una línea
sin_salto_final: |-   # | sin el
 final
con_extra: |+         # | conservando
 finales
|, >, |-, |+, >-... hay seis combinaciones y nadie se sabe las cuatro últimas de memoria. La buena noticia: el 99% de las veces quieres | o |-.
Mi postura, después de años de esto
YAML es un formato razonable para configuración escrita por humanos, corta y leída por una sola herramienta conocida. docker-compose.yml, un workflow de Actions, un values.yaml de Helm. Ahí cumple.
Es una mala elección para:
- Intercambio de datos entre sistemas: usa JSON. Tipos explícitos, parsers idénticos en todos lados, cero adivinación. Si necesitas validarlo, escribe un JSON Schema y listo.
- Configuración grande y compleja: cuando tu YAML necesita anclas, templates de Helm encima y tres capas de merge, ya no es configuración — es un lenguaje de programación mal diseñado. TOML para lo simple, HCL/CUE/Dhall para lo complejo.
- Cualquier cosa que parsee más de un lenguaje: la lotería 1.1 vs 1.2 te morderá.
Depura antes de desplegar
La forma más rápida de saber qué está entendiendo realmente el parser es convertir tu YAML a JSON y mirar el resultado: nuestro conversor YAML ⇄ JSON te muestra al instante si tu NO se convirtió en false, si tu on: es ahora true:, o si 1:20 salió como 80. Pega tu config, mira el JSON, y si ves un booleano donde debería haber un string — ya sabes dónde poner las comillas.
YAML no es el villano que pintan los hilos de odio en internet. Es solo un formato que confía demasiado en que sabes lo que haces. Y ahora ya lo sabes.
Artigos relacionados
Cómo Funciona `git diff` por Dentro: el Algoritmo de Myers Explicado
Cada git diff ejecuta un algoritmo publicado en 1986 que convierte "qué líneas cambiaron" en un problema de camino más corto en un grafo. Cómo funciona Myers, por qué a veces elige líneas raras y qué alternativas existen.

Normalización de Texto: el Paso Subestimado que Rompe Pipelines de Datos
Por qué la limpieza de texto (eliminar duplicados, ordenar, normalizar mayúsculas) es crítica antes de procesar datos, con ejemplos prácticos.