
Cómo Funciona `git diff` por Dentro: el Algoritmo de Myers Explicado
Cada git diff ejecuta un algoritmo publicado en 1986 que convierte "qué líneas cambiaron" en un problema de camino más corto en un grafo. Cómo funciona Myers, por qué a veces elige líneas raras y qué alternativas existen.
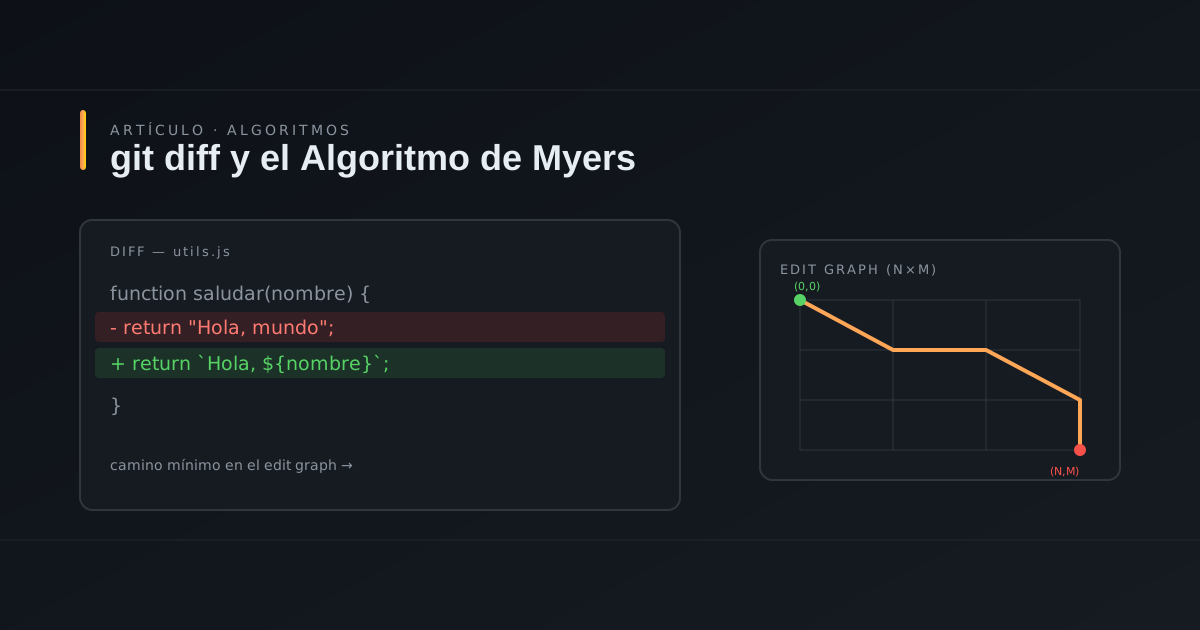
El algoritmo que usas cien veces al día sin saberlo
Haces git diff, miras una pull request en GitHub, comparas dos configuraciones con nuestro comparador de texto... y detrás de todas esas operaciones hay siempre la misma pregunta, aparentemente trivial: ¿qué líneas cambiaron?
Resulta que no es trivial en absoluto. Y la respuesta que usamos casi todo el mundo viene de un paper de 1986 escrito por Eugene Myers, un tipo que luego acabaría trabajando en el ensamblado del genoma humano. Porque sí, comparar secuencias de ADN y comparar versiones de código es, matemáticamente, el mismo problema.
Por qué la comparación ingenua no funciona
La primera idea que se le ocurre a cualquiera: comparar línea a línea. La línea 1 del archivo viejo contra la línea 1 del nuevo, la 2 contra la 2, y así.
Funciona fatal. Prueba a insertar una sola línea al principio de un archivo de quinientas: para el comparador ingenuo, todo el archivo cambió, porque cada línea se desplazó una posición. El diff mostraría 500 líneas borradas y 500 añadidas. Técnicamente correcto, prácticamente inútil.
Lo que queremos en realidad es otra cosa: el script de edición más corto posible. El mínimo número de líneas borradas y añadidas que transforma el archivo viejo en el nuevo. Si añadiste una línea al principio, el diff ideal es "una línea añadida", no "todo reescrito".
El truco matemático: LCS y el edit graph
Aquí viene la parte bonita. Encontrar el script de edición mínimo es equivalente a encontrar la subsecuencia común más larga (LCS) entre los dos archivos: las líneas que aparecen en ambos, en el mismo orden, aunque no estén juntas. Todo lo que no está en la LCS es, necesariamente, un borrado o una inserción.
El problema es que el algoritmo clásico de LCS con programación dinámica cuesta O(N·M) en tiempo y memoria. Para dos archivos de 10.000 líneas estamos hablando de una matriz de 100 millones de celdas. En 1986 eso era impensable; hoy sigue siendo una burrada para algo que debería ser instantáneo.
Myers tuvo una idea mejor: en lugar de rellenar una tabla gigante, mira el problema como un grafo.
El edit graph, explicado sin papel y lápiz
Imagina una cuadrícula donde el eje horizontal es el archivo viejo y el vertical es el nuevo. Quieres ir de la esquina superior izquierda (0,0) a la inferior derecha (N,M):
- Moverte a la derecha = borrar esa línea del archivo viejo
- Moverte hacia abajo = insertar esa línea del archivo nuevo
- Moverte en diagonal = las dos líneas coinciden, es gratis
        viejo:   A     B     C
               ┌───┬───┬───┐
      nuevo: A │ ╲ │   │   │
               ├───┼───┼───┤
             C │   │   │ ╲ │
               ├───┼───┼───┤
             B │   │ ╲ │   │
               └───┴───┴───┘
      → = borrar    ↓ = insertar    ╲ = coincidencia (gratis)
El mejor diff es el camino que usa menos movimientos horizontales y verticales — es decir, el que aprovecha más diagonales gratis.
La genialidad de Myers: no explores todo el grafo
Lo que hace el algoritmo es calcular, para cada número posible de ediciones D (0, 1, 2, 3...), hasta dónde puedes llegar en cada diagonal del grafo. Es voraz: con D ediciones permitidas, ¿cuál es el punto más lejano alcanzable en la diagonal k?
En cuanto uno de esos caminos toca la esquina (N,M), has encontrado el diff mínimo. Y aquí está la magia: el coste es O((N+M)·D), donde D es el número de líneas que realmente cambiaron.
Piensa lo que significa: en el mundo real, los diffs son pequeños. Cambias 20 líneas en un archivo de 5.000 y D es 20, no 10.000. El algoritmo es proporcional al tamaño del cambio, no al tamaño del archivo. Por eso git diff es instantáneo incluso en archivos enormes.
La versión que usa git (la librería xdiff) añade además una refinamiento de dividir y conquistar que reduce el consumo de memoria a lineal — mismo paper, segunda mitad.
Entonces, ¿por qué a veces el diff parece tonto?
Si has usado git lo suficiente has visto esto: añades una función nueva y el diff decide marcar el cambio en la llave de cierre de la función anterior, o agrupa las líneas de una forma rara que cuesta leer.
La razón es que el script de edición mínimo no es único. Si añades } y { en un sitio donde ya había llaves, hay varias formas igual de cortas de explicar el cambio, y el algoritmo devuelve la primera que encuentra — no necesariamente la que mejor lee un humano.
Por eso git lleva una capa de post-procesado: las heurísticas de "deslizamiento" y el indent-heuristic (activado por defecto desde git 2.14) empujan los bordes de los bloques de cambio hacia líneas en blanco o bordes de indentación, para que el resultado coincida mejor con cómo razonamos sobre el código. Es maquillaje sobre el mismo algoritmo de siempre.
Los rivales: minimal, patience e histogram
Git te deja elegir algoritmo con --diff-algorithm:
git diff --diff-algorithm=histogram
git diff --diff-algorithm=patience
git diff --diff-algorithm=minimal   # Myers sin atajos, más lento
- minimal es Myers puro, sin las optimizaciones que recortan la búsqueda. Útil cuando sospechas que las heurísticas te están ocultando un diff más pequeño.
- patience ancla la comparación en líneas que aparecen una sola vez en ambos archivos, y solo aplica recursión entre esos anclajes. Brilla cuando mueves bloques enteros de código: los diffs suelen respetar mejor la estructura.
- histogram es una extensión de patience que usa, como anclas, las líneas con menos ocurrencias. Es el algoritmo por defecto de JGit (la implementación Java de git que usan Eclipse y Gerrit) y mucha gente lo considera el que produce los diffs más legibles para código.
Dato curioso: aunque todo el mundo asocia git con Myers, si trabajas con Gerrit o con herramientas JetBrains a veces estás viendo histogram sin saberlo, y los mismos cambios se representan de forma distinta.
Más allá de las líneas
El mismo algoritmo funciona con cualquier secuencia. Si en lugar de líneas comparas caracteres, tienes git diff --word-diff o herramientas como diff-highlight. Si comparas tokens de un AST, tienes diff semántico — proyectos como difftastic usan tree-sitter para comparar estructura en lugar de texto, y detectan que foo(bar, baz) y foo( bar, baz, ) son "el mismo" código.
Y si comparas ADN, tienes bioinformática. Myers acabó en el proyecto Celera ensamblando el genoma humano con variantes de estas mismas ideas. La próxima vez que un diff te parezca raro, consuélate: estás usando un algoritmo que también ayudó a secuenciar el genoma.
Pruébalo tú mismo
La mejor forma de interiorizar esto es experimentar: abre nuestro comparador de texto, pega dos versiones de un texto y mira cómo reacciona el diff cuando insertas una línea al principio, cuando mueves un párrafo entero, o cuando cambias solo espacios. Verás en vivo las heurísticas de las que hablamos: qué se considera "línea modificada" versus "borrada más añadida", y cómo un solo carácter distinto marca toda la línea.
Cuarenta años después, el paper de Myers sigue siendo el corazón de la revisión de código moderna. No está mal para un algoritmo que cabe en cincuenta líneas.
관련 기사
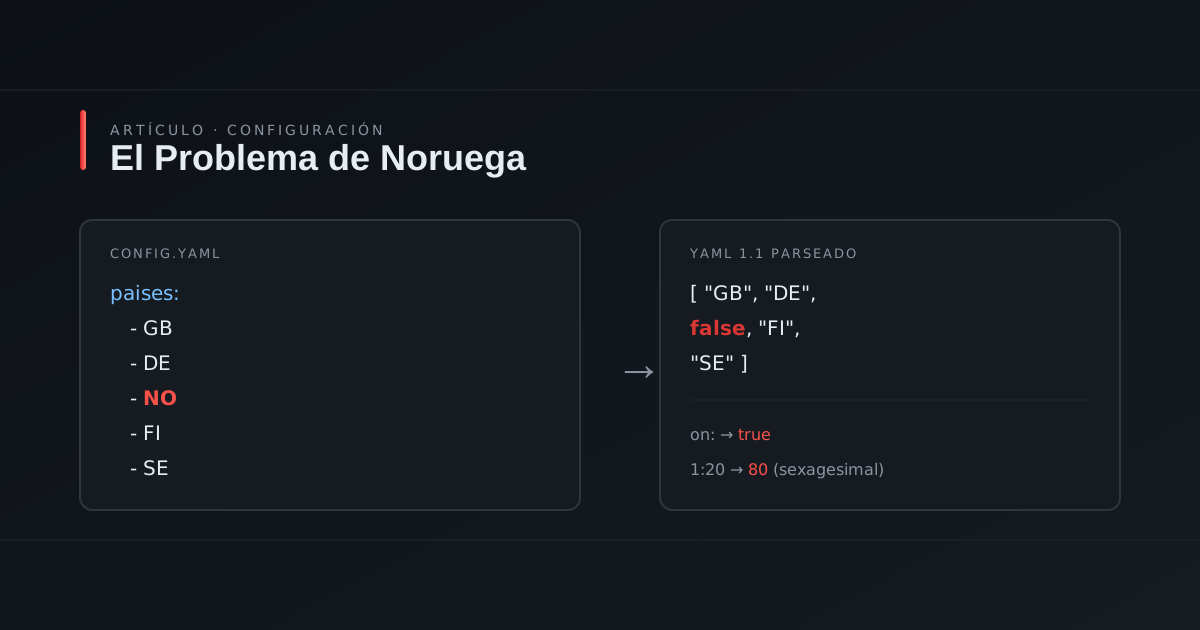
El Problema de Noruega y Otras Trampas de YAML que JSON No Tiene
En YAML el código de país NO se convierte en false, on es un booleano y 1:20 puede ser una hora o el número 80. Un repaso honesto a las trampas del formato que se comió la configuración de DevOps.

Normalización de Texto: el Paso Subestimado que Rompe Pipelines de Datos
Por qué la limpieza de texto (eliminar duplicados, ordenar, normalizar mayúsculas) es crítica antes de procesar datos, con ejemplos prácticos.