
URL Encoding: Por Qué %20 y + No Son lo Mismo (y Cuándo Importa)
El espacio se escribe %20 en una ruta pero + en un formulario, y confundirlos rompe búsquedas, firmas de APIs y enlaces de OAuth. Una guía práctica del percent-encoding para dejar de adivinar.
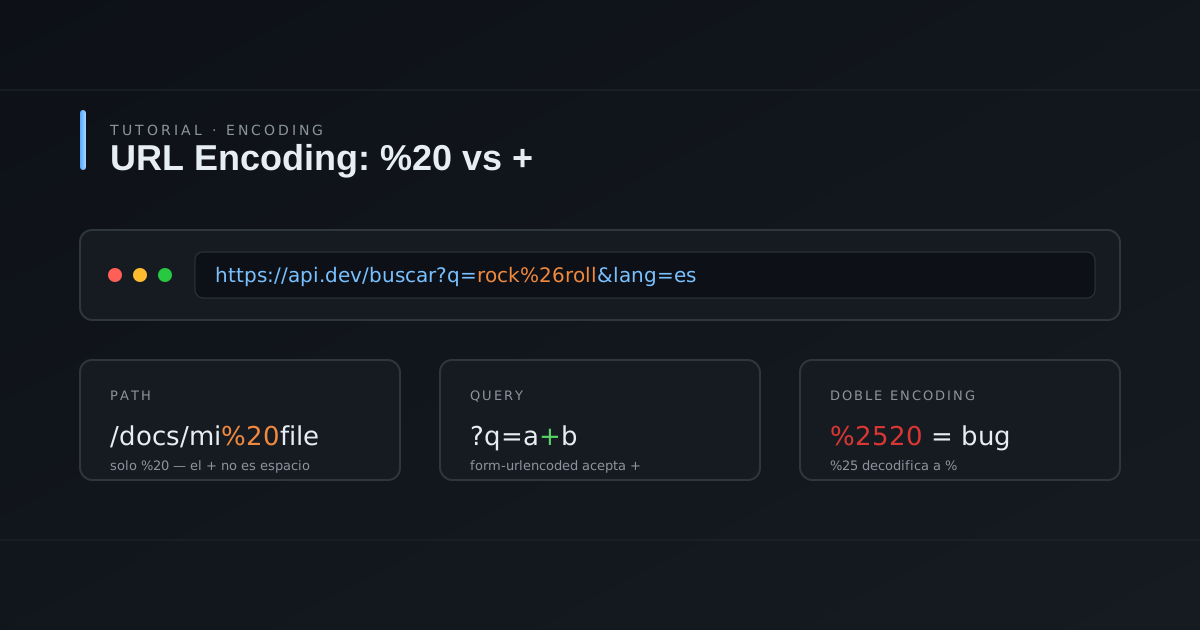
El bug que solo aparece con apellidos raros
El escenario es un clásico: todo funciona en tus tests hasta que un usuario real busca "rock & roll", se apellida "Núñez" o pone un "C++" en el formulario. De repente el backend recibe basura, la firma de la petición no valida o el redirect de OAuth devuelve un 400 críptico.
El culpable casi siempre es el mismo: alguien concatenó strings en una URL sin entender qué es el percent-encoding, cuándo el espacio es %20, cuándo es +, y por qué encodeURIComponent y encodeURI no son intercambiables. Vamos a arreglar eso de una vez.
Por qué existe esto: caracteres con doble vida
Una URL no es un saco de texto libre. El RFC 3986 divide los caracteres en dos grupos:
- Unreserved: letras, dígitos y cuatro símbolos (
-,_,.,~). Van tal cual, siempre. - Reserved: los que tienen significado estructural —
:,/,?,#,&,=,+, y otros. Se usan para separar las partes de la URL.
El problema es que a veces quieres usar un carácter reservado como dato, no como estructura. En https://api.com/buscar?q=rock&roll, ese & no es parte del valor rock&roll: para el servidor son dos parámetros (q=rock y un misterioso roll vacío). Ahí entra el percent-encoding: cada byte "peligroso" se escribe como % seguido de su código hexadecimal. & es el byte 0x26, así que se escribe %26.
https://api.com/buscar?q=rock%26roll          → q = "rock&roll"
https://api.com/buscar?q=Jos%C3%A9+N%C3%BA%C3%B1ez  → q = "José Núñez"
Ojo al detalle importante: el percent-encoding opera sobre bytes, no sobre caracteres. La é en UTF-8 son dos bytes (0xC3 0xA9), de ahí el %C3%A9. Si alguna vez ves salidas tipo Nuñez, lo que pasó es que bytes UTF-8 se interpretaron como Latin-1 — el encoding se rompió en otro punto de la cadena.
%20 contra +: la guerra de los dos estándares
Aquí está la confusión número uno. Hay dos convenciones para el espacio, y conviven:
- RFC 3986 (la URL "pura"): el espacio se escribe
%20. Punto. - application/x-www-form-urlencoded (los formularios HTML): el espacio se escribe
+, y el+literal se escribe%2B.
¿Y dónde se aplica cada una? Esta es la tabla mental que necesitas:
- En el path (
/docs/mi archivo.pdf): siempre%20. Un+en el path es literalmente el carácter más, no un espacio./docs/mi+archivo.pdfbusca un archivo llamadomi+archivo.pdf. - En la query string (
?q=mi+búsqueda): depende de quién lea. La tradición form-urlencoded acepta+como espacio, y la mayoría de servidores lo decodifican así. Pero es convención, no ley universal — hay APIs y frameworks que tratan el+como literal incluso en la query.
La regla práctica que nunca falla: genera %20 para espacios siempre que puedas (es válido en ambos mundos), y al decodificar, acepta los dos. Lo que no puedes hacer es lo contrario: enviar + por un path y esperar que alguien lo lea como espacio.
encodeURIComponent vs encodeURI: el error del millón
JavaScript tiene dos funciones y la gente elige mal constantemente:
encodeURIComponent("rock & roll, 100%")
// "rock%20%26%20roll%2C%20100%25"

encodeURI("https://ej.com/ruta?x=rock & roll")
// "https://ej.com/ruta?x=rock%20&%20roll"
encodeURIComponentcodifica todo lo reservado:/,?,&,=,#,+,,, etc. Es lo que quieres para un valor individual: un parámetro de query, un segmento de path, un token.encodeURIdeja intactos los caracteres estructurales (/ ? & = #), porque asume que le pasas una URL completa y solo quiere escapar espacios y no-ASCII.
El bug canónico: meter un valor con encodeURI pensando que ya está "escapado":
const ciudad = "Trinidad & Tobago";
fetch(`/api/clima?ciudad=${encodeURI(ciudad)}`);
// → /api/clima?ciudad=Trinidad & Tobago
//    el & sigue suelto: son DOS parámetros. Bug.

fetch(`/api/clima?ciudad=${encodeURIComponent(ciudad)}`);
// → /api/clima?ciudad=Trinidad%20%26%20Tobago  ✓
Regla nemotécnica: component para componentes (piezas), sin component para URLs enteras. Si lo que codificas es un dato, encodeURIComponent. Y olvida escape() — está deprecada desde ES3 y rompe Unicode.
URLSearchParams: el atajo con truco
const params = new URLSearchParams({ q: "rock & roll", pag: "2" });
params.toString();  // "q=rock+%26+roll&pag=2"
Es la forma correcta de construir queries hoy en día, con un matiz: serializa el espacio como + (estilo form-urlencoded). Válido en la mayoría de contextos, pero si firmas peticiones o comparas strings de URL exactas (OAuth, AWS Signature), recuerda que + ≠ %20 a nivel de bytes — dos representaciones del mismo espacio producen firmas distintas. Ahí suele vivir el "mi firma no valida y no sé por qué" de las 3 AM.
El doble encoding: %2520 y la sopa de porcentajes
Si %20 es un espacio, ¿qué es %2520? El percent-encoding de un percent-encoding: %25 es el % literal, así que %2520 decodifica una vez a %20 y dos veces a espacio.
Esto pasa más de lo que crees:
// El valor ya venía codificado de otra capa
const ya = "rock%20%26%20roll";
encodeURIComponent(ya);  // "rock%2520%2526%2520roll" — desastre
Síntomas en la vida real: logs con %2525 por todas partes, redirects de OAuth que fallan porque el redirect_uri se codificó dos veces, y nombres de archivo en S3 que literalmente se llaman foto%2520final.jpg. La cura es disciplina: decide en qué capa se codifica (normalmente la más externa, la que serializa la URL final) y pasa valores crudos hasta ahí. Codificar "por si acaso" en cada capa es como envolver un regalo en siete papeles: nadie sabe ya qué hay dentro.
El lado oscuro: decodificar antes de validar
Del otro lado del cable, el percent-encoding es también un vector de ataque viejo conocido:
GET /files/%2e%2e%2f%2e%2e%2fetc%2fpasswd
%2e es ., %2f es /. Si tu servidor decodifica el path y después comprueba que no contiene ../, todo bien. Si la comprobación de seguridad mira el string antes de decodificar, el atacante acaba de salir de tu directorio público. Variantes divertidas: %252e%252e%252f (doble encoding, sobrevive una decodificación), ..%c0%af (encoding inválido que algunos parsers antiguos aceptaban).
La lección para tu lado del servidor: decodifica una sola vez, valida después, y nunca construyas paths de fichero uniendo strings decodificados sin verificación de que el resultado queda dentro del directorio permitido. Los CVEs de path traversal de 2026 siguen usando este truco de 1999.
Checklist para no volver a depurar esto
- Valor suelto →
encodeURIComponent. URL completa →encodeURI. Nuncaescape(). - Queries: usa
URLSearchParamsen vez de concatenar strings — pero recuerda que emite+para espacios. - En el path, solo
%20. Un+ahí no es un espacio, es el carácter más. - Codifica una vez, en la capa que serializa la URL. Pasa datos crudos hasta entonces.
- Si firmas peticiones (OAuth, AWS, webhooks con HMAC): normaliza a
%20y mayúsculas en los hex (%2F, no%2f) — el estándar de firma es estricto con la forma exacta. - Al decodificar en servidor: una pasada, luego valida. Path traversal vive en el orden contrario.
- No-ASCII siempre en UTF-8 antes de percent-encodear. La
ñson dos bytes, no uno.
Pruébalo sin montar un servidor
La forma más rápida de asimilar las diferencias es verlas: nuestro codificador URL te muestra exactamente cómo queda cualquier texto — prueba con rock & roll, con José Núñez, con una URL que ya venga codificada para ver el efecto del doble encoding. Y el decodificador URL hace el camino inverso: pégale ese q=rock%26roll sospechoso de tus logs o ese redirect_uri raro de OAuth y mira qué está recibiendo realmente el servidor.
El percent-encoding es de esos temas que parecen de apuntes de primero de carrera hasta que te rompe una integración un viernes. Media hora entendiéndolo hoy te ahorra esa tarde.
Artículos relacionados
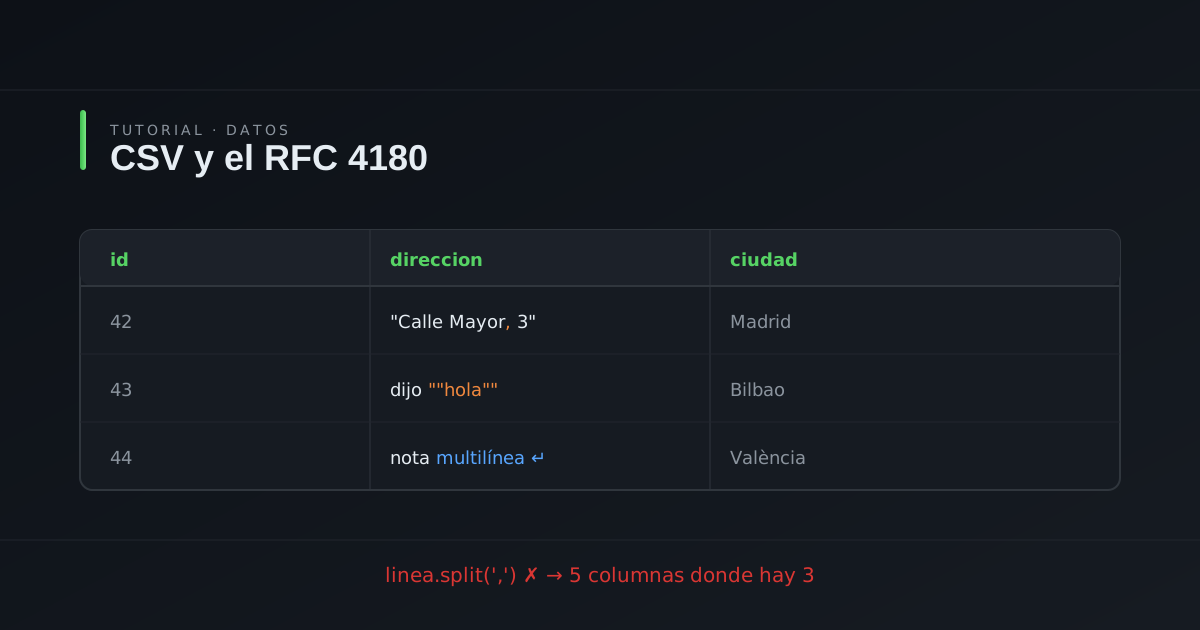
CSV Parece Fácil Hasta Que Llega una Coma Dentro de una Celda: RFC 4180 en la Práctica
split(",") funciona en la demo y muere en producción. Qué dice realmente el RFC 4180, las trampas que no dice (encoding, tipos, Excel) y cómo parsear y generar CSV sin romper nada.
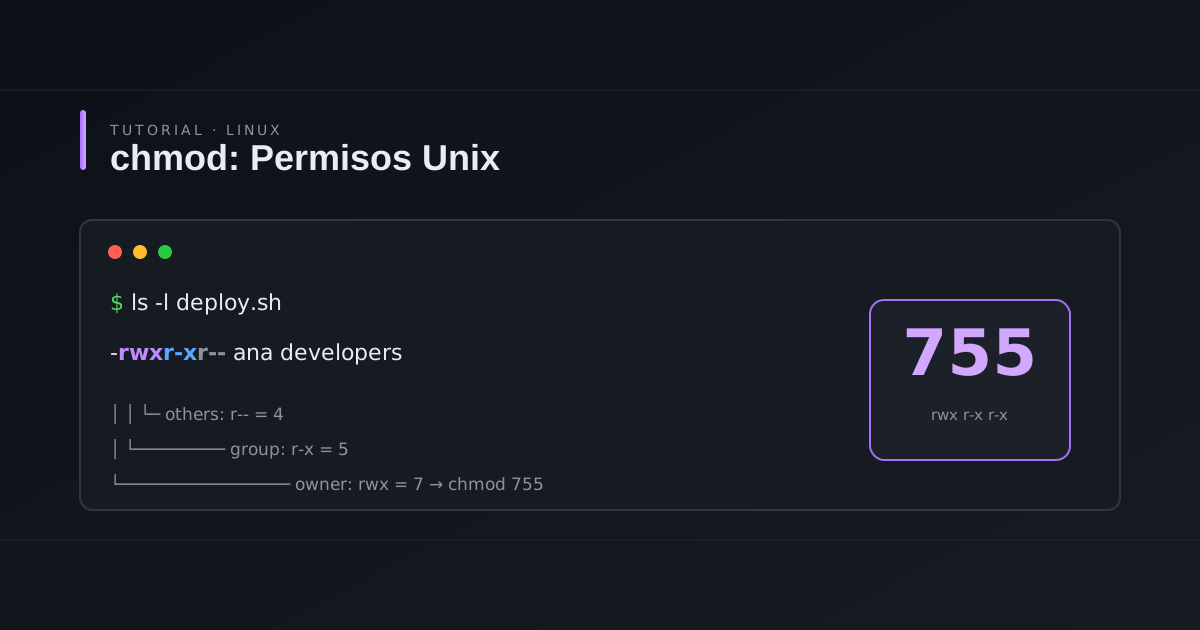
chmod 755 vs rwxr-xr-x: Domina los Permisos Unix de una Vez
Qué significa realmente rwxr-xr-x, cómo traducir entre octal y simbólico sin calculadora, los bits especiales que casi nadie entiende (setuid, setgid, sticky) y por qué chmod 777 "funciona" pero es una mala idea.